
Timestral: modelos pequenos e a grande questão da data dos dados
A promoção de amanhã já está no calendário. As vendas de amanhã, não. Um recurso de previsão precisa preservar essa diferença, mesmo quando as duas colunas estão lado a lado no mesmo banco de dados.
A Mistral apresentou o Timestral em 15 de outubro, e o assunto voltou a ganhar atenção nesta semana. São quatro modelos numéricos, de 5 a 209 milhões de parâmetros, que recebem séries relacionadas e informações externas para produzir distribuições de valores futuros. A liderança em três benchmarks zero-shot e os tempos em CPU são resultados do fornecedor, não medições da NxCode.
Para quem adiciona previsão de demanda, capacidade ou monitoramento a um produto, ficou mais fácil obter o componente numérico. Continua difícil reconstruir as informações disponíveis no instante da previsão. Inspecionamos código e documentação, sem executar os pesos ou reproduzir precisão e latência. Um varejista hipotético ajuda a acompanhar essa fronteira até um teste histórico útil.
Um modelo pequeno pode devolver mais que uma estimativa
Uma série temporal organiza observações no tempo. Um modelo pré-treinado aplica padrões aprendidos a uma série nova. Zero-shot significa dispensar um treinamento específico para essa série; não elimina o histórico nem torna previsível toda mudança comercial.
O cartão do modelo 209 M descreve até 32768 passos históricos, grupos de 32 passos e previsão de até 1024 passos em uma passagem. Passos são observações, não tokens de linguagem.96 passos equivalem a quatro dias em dados horários ou a um dia em intervalos de quinze minutos. Frequência e fuso horário precisam acompanhar os valores.
Cada instante futuro recebe 21 quantis. A mediana é a estimativa central. O quantil 0,9 estima um limite abaixo do qual ficariam 90% dos resultados, caso as probabilidades estejam calibradas. Limites ordenados não demonstram que as observações reais seguem essa proporção.
Imagine uma loja planejando a equipe de amanhã. É um exemplo, não um caso de cliente. A mediana ajuda a descrever demanda comum, enquanto um quantil alto apoia uma escolha mais cautelosa. Duração dos turnos, meta de serviço e custo da falta de pessoal continuam sendo decisões do aplicativo. O intervalo deve ter uma decisão definida e ser conferido em datas reservadas.
O dado mais útil também pode revelar a resposta
Uma covariável é outra entrada que ajuda a explicar o alvo, como visitas anteriores ou uma promoção programada. A interface separa entradas históricas das futuras conhecidas. Estas cobrem o histórico e todo o horizonte solicitado.
Uma promoção aprovada antes do corte é informação futura conhecida; o movimento real de amanhã não é. Uma previsão do tempo publicada hoje difere da temperatura medida amanhã. Trocar a previsão arquivada pela observação no teste histórico dá ao modelo uma informação indisponível em produção.
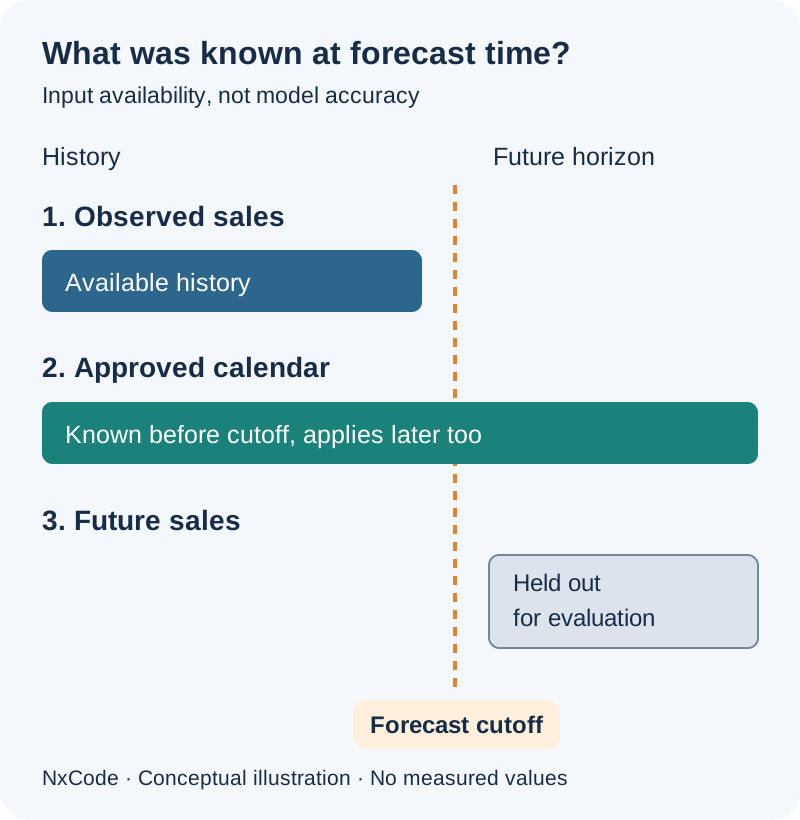
Esquema original da NxCode sobre disponibilidade das entradas no corte. Os blocos não representam previsões do modelo nem medições de precisão.
Planos também mudam. A versão atual do armazém pode conter revisões posteriores à previsão. Guarde tanto o momento de vigência quanto o de disponibilidade. A promoção acontece sexta-feira, mas talvez não fosse conhecida na previsão de quinta.
Uma demonstração com muitas entradas externas não é automaticamente mais confiável que outra só com histórico. Compare ambas com cortes e alvos iguais, usando apenas covariáveis disponíveis naquela ocasião. Assim é possível avaliar o valor adicional sob condições realistas.
A máscara de atenção não corrige uma junção errada
A implementação das máscaras dá visibilidade diferente a cada linha. Entradas futuras conhecidas podem ler sua janela inteira, mas restrições impedem que leiam linhas-alvo e devolvam o futuro do próprio alvo à previsão. O código permite examinar essa separação.
Ela não comprova quando um valor surgiu no mundo real. Se as vendas realizadas amanhã forem fornecidas numa coluna chamada campanha, a arquitetura não restaura o significado perdido. Preparação dos dados faz parte da correção do sistema.
Horizontes longos são gerados em blocos, com as medianas do bloco anterior reincorporadas ao contexto. Retornar mais de 1024 passos não equivale a prever conjuntamente todo o horizonte de uma vez. Tampouco produz um conjunto completo de cenários futuros correlacionados.
Somar sete quantis superiores diários não gera automaticamente o quantil semanal da mesma probabilidade. A dependência entre dias importa. Avalie o agregado mostrado ao usuário, sem presumir que toda operação mantém o significado probabilístico das saídas.
Três primeiros lugares são o começo da seleção
A Mistral informa liderança entre modelos pré-treinados zero-shot no GIFT-Eval, TIME e fev-bench. A documentação mostra condições distintas: covariáveis históricas no GIFT-Eval, históricas e futuras conhecidas no fev-bench, nenhuma no TIME. Não são três repetições do mesmo experimento.
MASE compara o erro absoluto de uma estimativa pontual com uma escala de referência simples. Pontuações de quantis examinam a distribuição. Um bom centro não garante intervalos úteis. Preserve métrica, grupo de comparação e composição dos dados ao interpretar a posição.
Os responsáveis pelo GIFT-Eval distinguem categoria do modelo, sobreposição de treinamento e vazamento de teste. Zero-shot exclui treinar com as partes de treino e teste do benchmark. Pré-treinado é uma categoria mais ampla. Uma afirmação com condições não deve virar superioridade frente a qualquer método.
O artigo IND-Eval, submetido em 12 de outubro, enfatiza dados industriais multivariados e intervalos menores. Há exceções por fonte mesmo quando um modelo lidera no agregado. Timestral não foi avaliado. A lição é metodológica: a média pode esconder o domínio importante ao produto, sem provar sucesso ou fracasso industrial do Timestral.
CPU e licença dos pesos são perguntas separadas
O pacote usa PyTorch, NumPy, safetensors e Hugging Face Hub. O exemplo de CPU da Mistral utiliza oito threads de servidor, três semanas de histórico de quinze minutos e horizonte de um dia. Os 10 ms do menor modelo e 140 ms do maior valem para essa configuração, não como promessa para notebook, serviço ocupado ou milhares de variáveis conjuntas.
Meça carga fria, inferência estável e requisição completa separadamente. Registre lote, quantidade de séries, covariáveis e threads. Baixar os pesos custa algo diferente de prever num processo pronto. Compatibilidade com CPU permite estudar o orçamento, mas ainda não mede o custo do serviço.
O código é Apache 2.0, enquanto os pesos 209 M são Modified MIT. O texto não autoriza exercer os direitos caso a receita mensal global consolidada da empresa ou empregador tenha excedido 20 milhões de dólares no mês anterior. Ele aponta licença comercial ou serviço hospedado e exige preservar avisos. Chamar ambos simplesmente de código aberto MIT omite uma condição material. Registre pacote e pesos separadamente no inventário de implantação.
O primeiro teste precisa permitir a vitória da regra antiga
Comece com uma ação reversível: recomendar reforço nas horas movimentadas enquanto o gerente mantém a decisão. Antes dos resultados, fixe lojas, datas reservadas, horário de emissão, horizonte e regra existente. Caso contrário, a equipe pode ajustar o experimento até o modelo parecer útil.
A biblioteca fev separa passado e futuro restrito a entradas conhecidas em cada janela. Seus resumos guardam definição da tarefa, impressão digital dos dados e configurações. Essa organização serve ao experimento interno sem alegar reprodução do benchmark completo.
| Registro | O que preservar na loja |
|---|---|
| Emissão | Loja, fuso, corte e horizonte |
| Entradas | Histórico e revisão promocional disponível naquele momento |
| Comparações | Regra atual, referência sazonal ingênua, histórico puro, covariáveis válidas |
| Saídas | Revisão, configurações, mediana e quantis escolhidos |
| Resultado | Valores reservados, erros por loja e horizonte, cobertura e efeito na equipe |
A referência sazonal ingênua repete, por exemplo, a mesma hora da semana anterior. Mantenha-a: se o modelo não melhora essa regra na decisão-alvo, a complexidade extra tem pouca justificativa. Separe períodos calmos e de pico para a média não esconder turnos importantes.
Confira cobertura e largura juntas. Um intervalo enorme cobre muito, mas pouco ajuda a planejar; um estreito pode perder picos. Examine a contribuição das entradas externas, revisões posteriores e estabilidade em novas datas reservadas.
Um assistente pode explicar os números ou buscar a política promocional. Ligue seu texto às saídas, ao corte e às entradas arquivadas para não substituir a estimativa silenciosamente. Para quem constrói com NxCode, o primeiro recurso útil é uma previsão que o usuário possa inspecionar e rejeitar. A adoção deve depender de um experimento capaz de recomendar manter a regra anterior.
